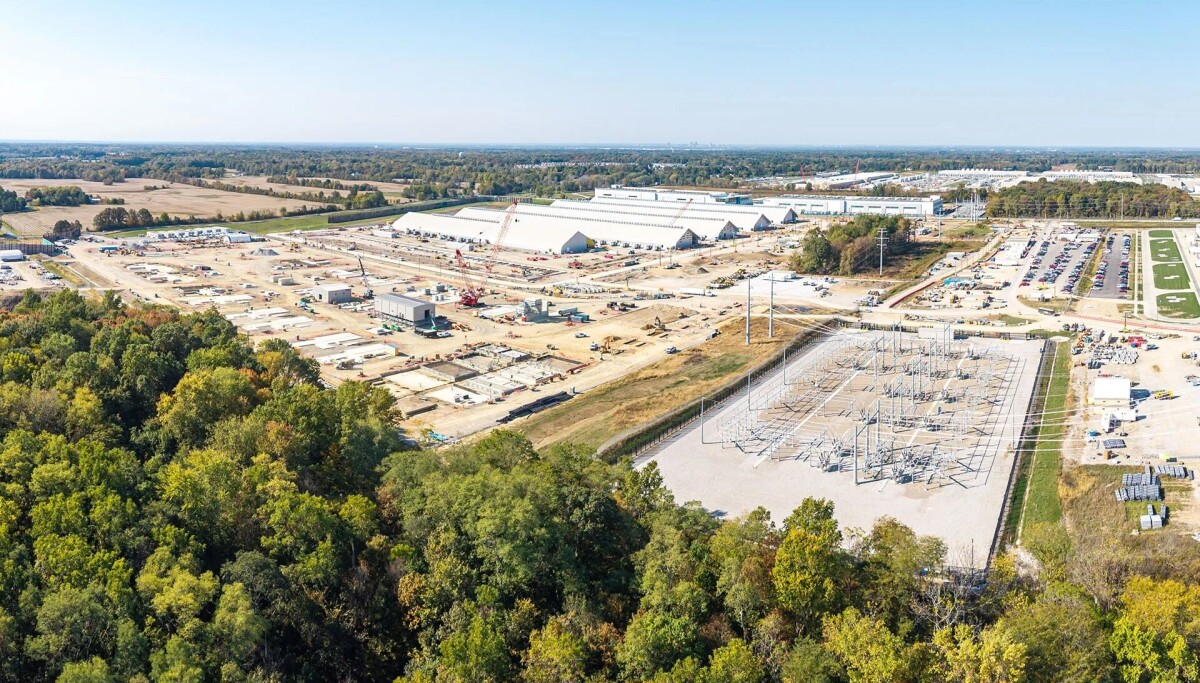
Meta, il colosso dei social media, ha rivelato che oltre l’11% delle GPU presenti nel suo supercluster Prometheus, situato a New Albany, Ohio, sono attualmente non operative o in attesa di intervenire in caso di guasti. Questa enorme riserva di GPU ridondanti rappresenta solo una delle molteplici misure adottate dall’azienda per garantire il regolare andamento delle sue operazioni di addestramento dell’intelligenza artificiale.
Prometheus è uno dei più grandi progetti di calcolo mai realizzati da Meta, alimentato dai sistemi rack Nvidia Grace Blackwell e, nel prossimo futuro, da quelli Vera Rubin. L’obbiettivo è arrivare a una capacità di un gigawatt, distribuita su circa un milione di acceleratori.
Chiunque abbia lavorato su un grande cluster di calcolo sa che, a maggiori dimensioni, corrispondono inevitabilmente maggiori problemi. Ad esempio, in un nodo con otto GPU, la probabilità di guasti è relativamente bassa, ma in un cluster da 100.000 GPU, i guasti diventano inevitabili. Meta sta sviluppando un sistema dieci volte più grande, che richiede addestramenti distribuiti su più data center, rendendo necessario mantenere il funzionamento continuo per cui è diventato fondamentale affrontare problemi di guasto.
GPU inattive per garantire la continuità
All’inizio della fase di implementazione di Prometheus, nel periodo di avvio, Meta ha registrato circa 1.000 interruzioni al giorno ogni 8.000 GPU. Queste interruzioni non indicano necessariamente guasti delle GPU, ma possono derivare da crash o timeout, costringendo il processo di addestramento a fermarsi e a tornare all’ultimo checkpoint valido. Nel corso di un anno, l’azienda è riuscita a ridurre le interruzioni del 99%, portandole a sole 11 al giorno per ogni 8.000 GPU.
Uno dei metodi per raggiungere questo obiettivo è stato mantenere alcune GPU di Prometheus in riserva. La struttura è attualmente composta da sistemi GB200 e GB300, ognuno con 72 GPU per dominio NVLink, ma solo 64 di esse vengono utilizzate in ogni dato momento, mentre le altre otto funzionano come “spare”. Anche se queste GPU di riserva non sono impiegate nel processo di addestramento principale, possono comunque eseguire lavori opportunistici, prontamente fermabili in caso di guasto di un’altra GPU.
Resilienza parallela
Per mitigare ulteriormente i problemi, Meta ha sfruttato il fatto che i lavori di addestramento su larga scala utilizzano in genere il parallelismo dati, dove multiple copie del modello sono operative all’interno del cluster. Questo consente di isolare eventuali guasti, riducendo l’impatto di un guasto hardware permettendo a una singola copia difettosa di essere portata offline mentre il resto del cluster continua a lavorare. Gli stati dei modelli vengono salvati continuamente in modo da non dover ripartire da zero in caso di problemi.
Le sfide del NVLink
Uno dei problemi più complessi affrontati da Meta è stato il funzionamento delle interconnessioni NVLink utilizzate per collegare le 72 GPU, che devono comportarsi come un grande acceleratore. I precedenti sistemi basati su H100 e H200 disponevano di solo otto GPU per dominio NVLink, ma questo è stato amplificato a nove volte di più con la generazione Blackwell di Nvidia.
Meta ha dovuto implementare un sistema di telemetria continua e condurre diagnostiche per isolare i link deboli prima che i sistemi venissero messi in produzione. La gestione dell’alimentazione è stata un’altra sfida, poiché l’accensione e lo spegnimento di decine di migliaia di GPU possono generare picchi di consumo energetico, rischiando di sopraffare l’attrezzatura di alimentazione. Meta sostiene di aver raggiunto oltre l’85% di “goodput” per il pre-addestramento e oltre il 90% per l’apprendimento per rinforzo nel suo modello più recente, Muse Wonder.
Le ambizioni di Meta non si fermano qui; l’azienda punta a ridurre ulteriormente il tasso di interruzione a sole due per giorno per ogni 8.000 GPU, pari a circa 100.000 ore GPU prima di un’interruzione.
Aggiornamento: Dopo la pubblicazione, Meta ha contattato per chiarire che i calcoli di riserva vengono utilizzati per eseguire lavori opportunistici che possono essere interrotti in caso di guasti. Abbiamo aggiornato la nostra notizia e il titolo per riflettere ciò.